
สารบัญบทความ
ปัญญาประดิษฐ์ (AI) เริ่มช่วยสืบหาโรค อ่านภาพ และเตรียมข้อมูลก่อนพบแพทย์ได้ดีขึ้น แต่ความแม่นยำในชุดทดสอบยังไม่เท่ากับประโยชน์ต่อผู้ป่วยจริง ต่อไปนี้คือ 5 งานวิจัยที่ตีพิมพ์ในวารสารช่วงกันยายน–ตุลาคม 2026 ตรวจสอบข้อมูลถึง 25 ตุลาคม 2026
1. MAI-DxO: สืบหาโรคทีละขั้น
MAI-DxO ของ Microsoft จำลองบทบาทผู้ร่วมวินิจฉัยหลายบทบาท เพื่อเสนอโรคที่เป็นไปได้ เลือกคำถามและการตรวจ แล้วปรับข้อสรุปตามหลักฐานใหม่ โดยใช้ระบบทดสอบ SDBench ในภาพที่ 1 ผลใน Science รายงานความถูกต้องประมาณ 83% เทียบกับแพทย์ 36% สำหรับเคสซับซ้อนจาก NEJM เมื่อแพทย์เปิดแหล่งอ้างอิงได้ และประมาณ 80% เทียบกับ 47% สำหรับเคสฉุกเฉิน [1]
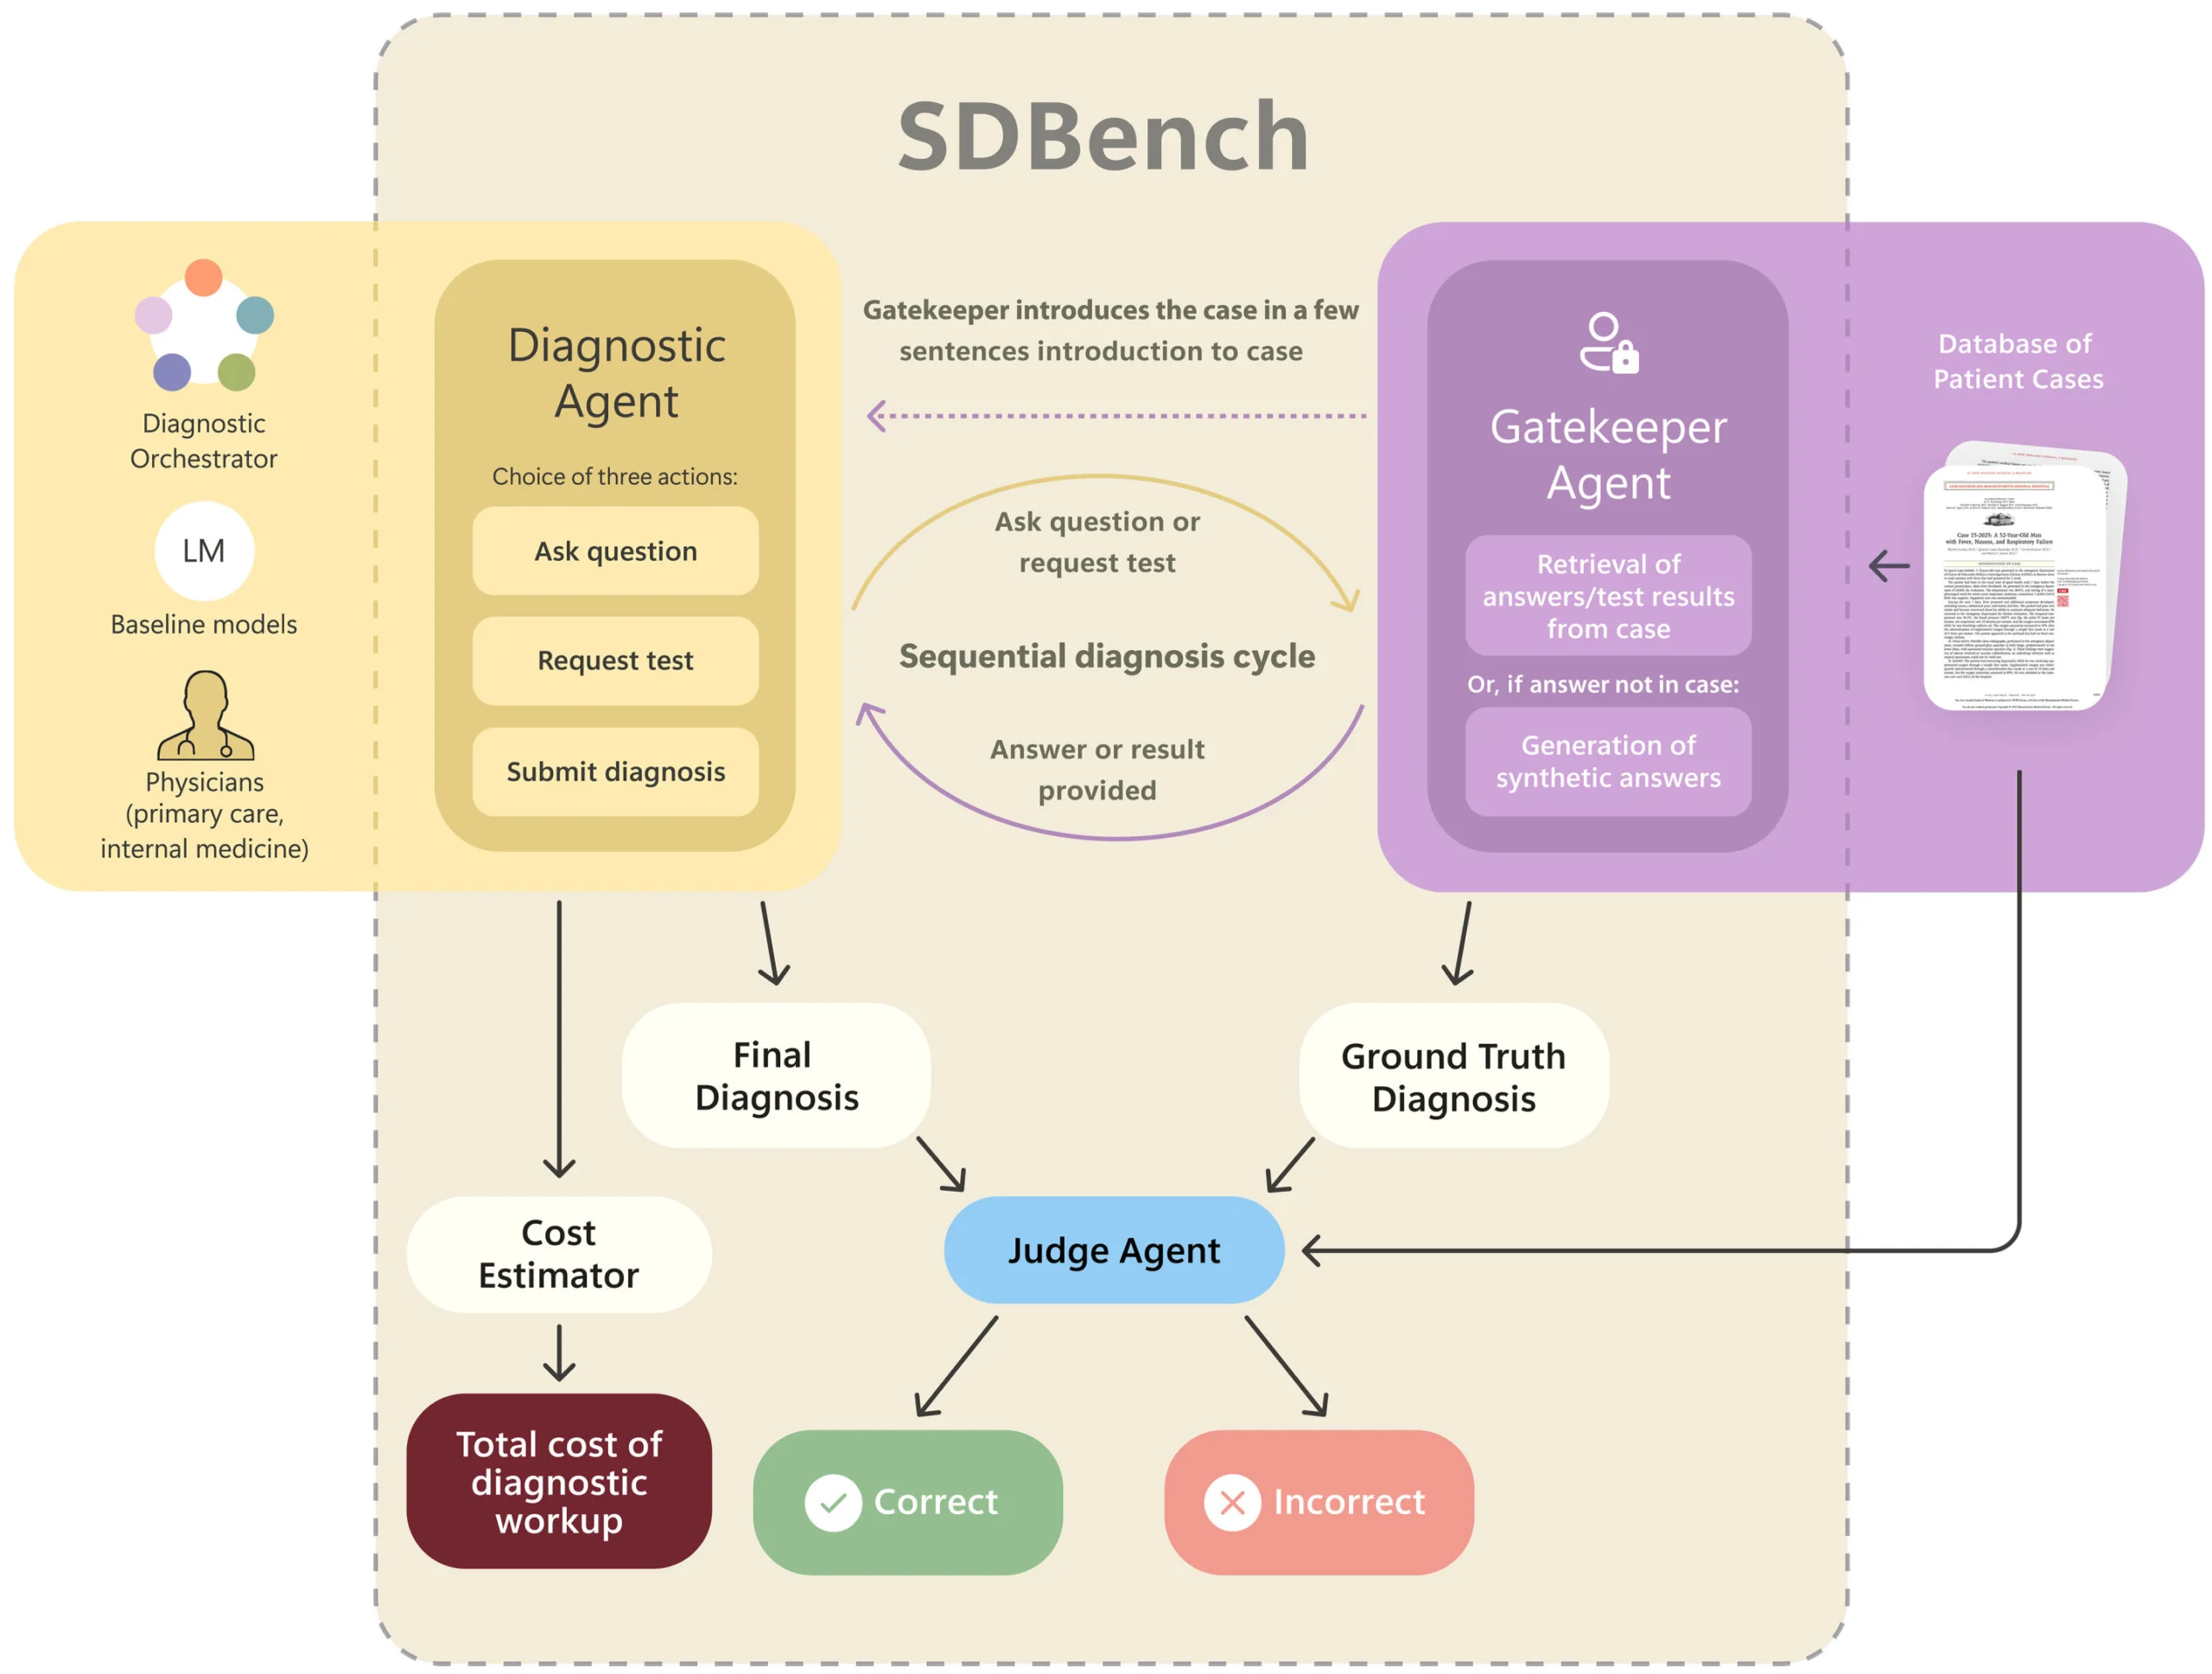
ข้อจำกัด: เป็นการจำลองจากข้อมูลย้อนหลังและทดสอบโดยทีมผู้พัฒนา ไม่ใช่การดูแลผู้ป่วยข้างเตียงหรือการเทียบกับทีมแพทย์เฉพาะทาง จึงยังสรุปไม่ได้ว่า AI รักษาผู้ป่วยได้ดีกว่า หรือประหยัดค่าใช้จ่ายจริง
2. EAGLE: ใช้ CT เดิมคัดคนที่ควรตรวจหลอดอาหารต่อ
EAGLE ตรวจรอยโรคหลอดอาหารจาก CT ทรวงอกแบบไม่ฉีดสารทึบรังสี งานใน Nature Medicine ประเมินรวม 80,612 รายจาก 12 ศูนย์ใน 3 ประเทศ การทดสอบภายนอก 11,466 รายให้ความไวต่อมะเร็ง 90.0% และความจำเพาะ 98.5% แต่ความไวต่อรอยโรคก่อนมะเร็งอยู่ที่ 52.5% [2] ภาพที่ 2a–c แสดงการพัฒนาโมเดล กลุ่มตรวจสอบ และแนวทางแทรก AI ในการคัดกรอง
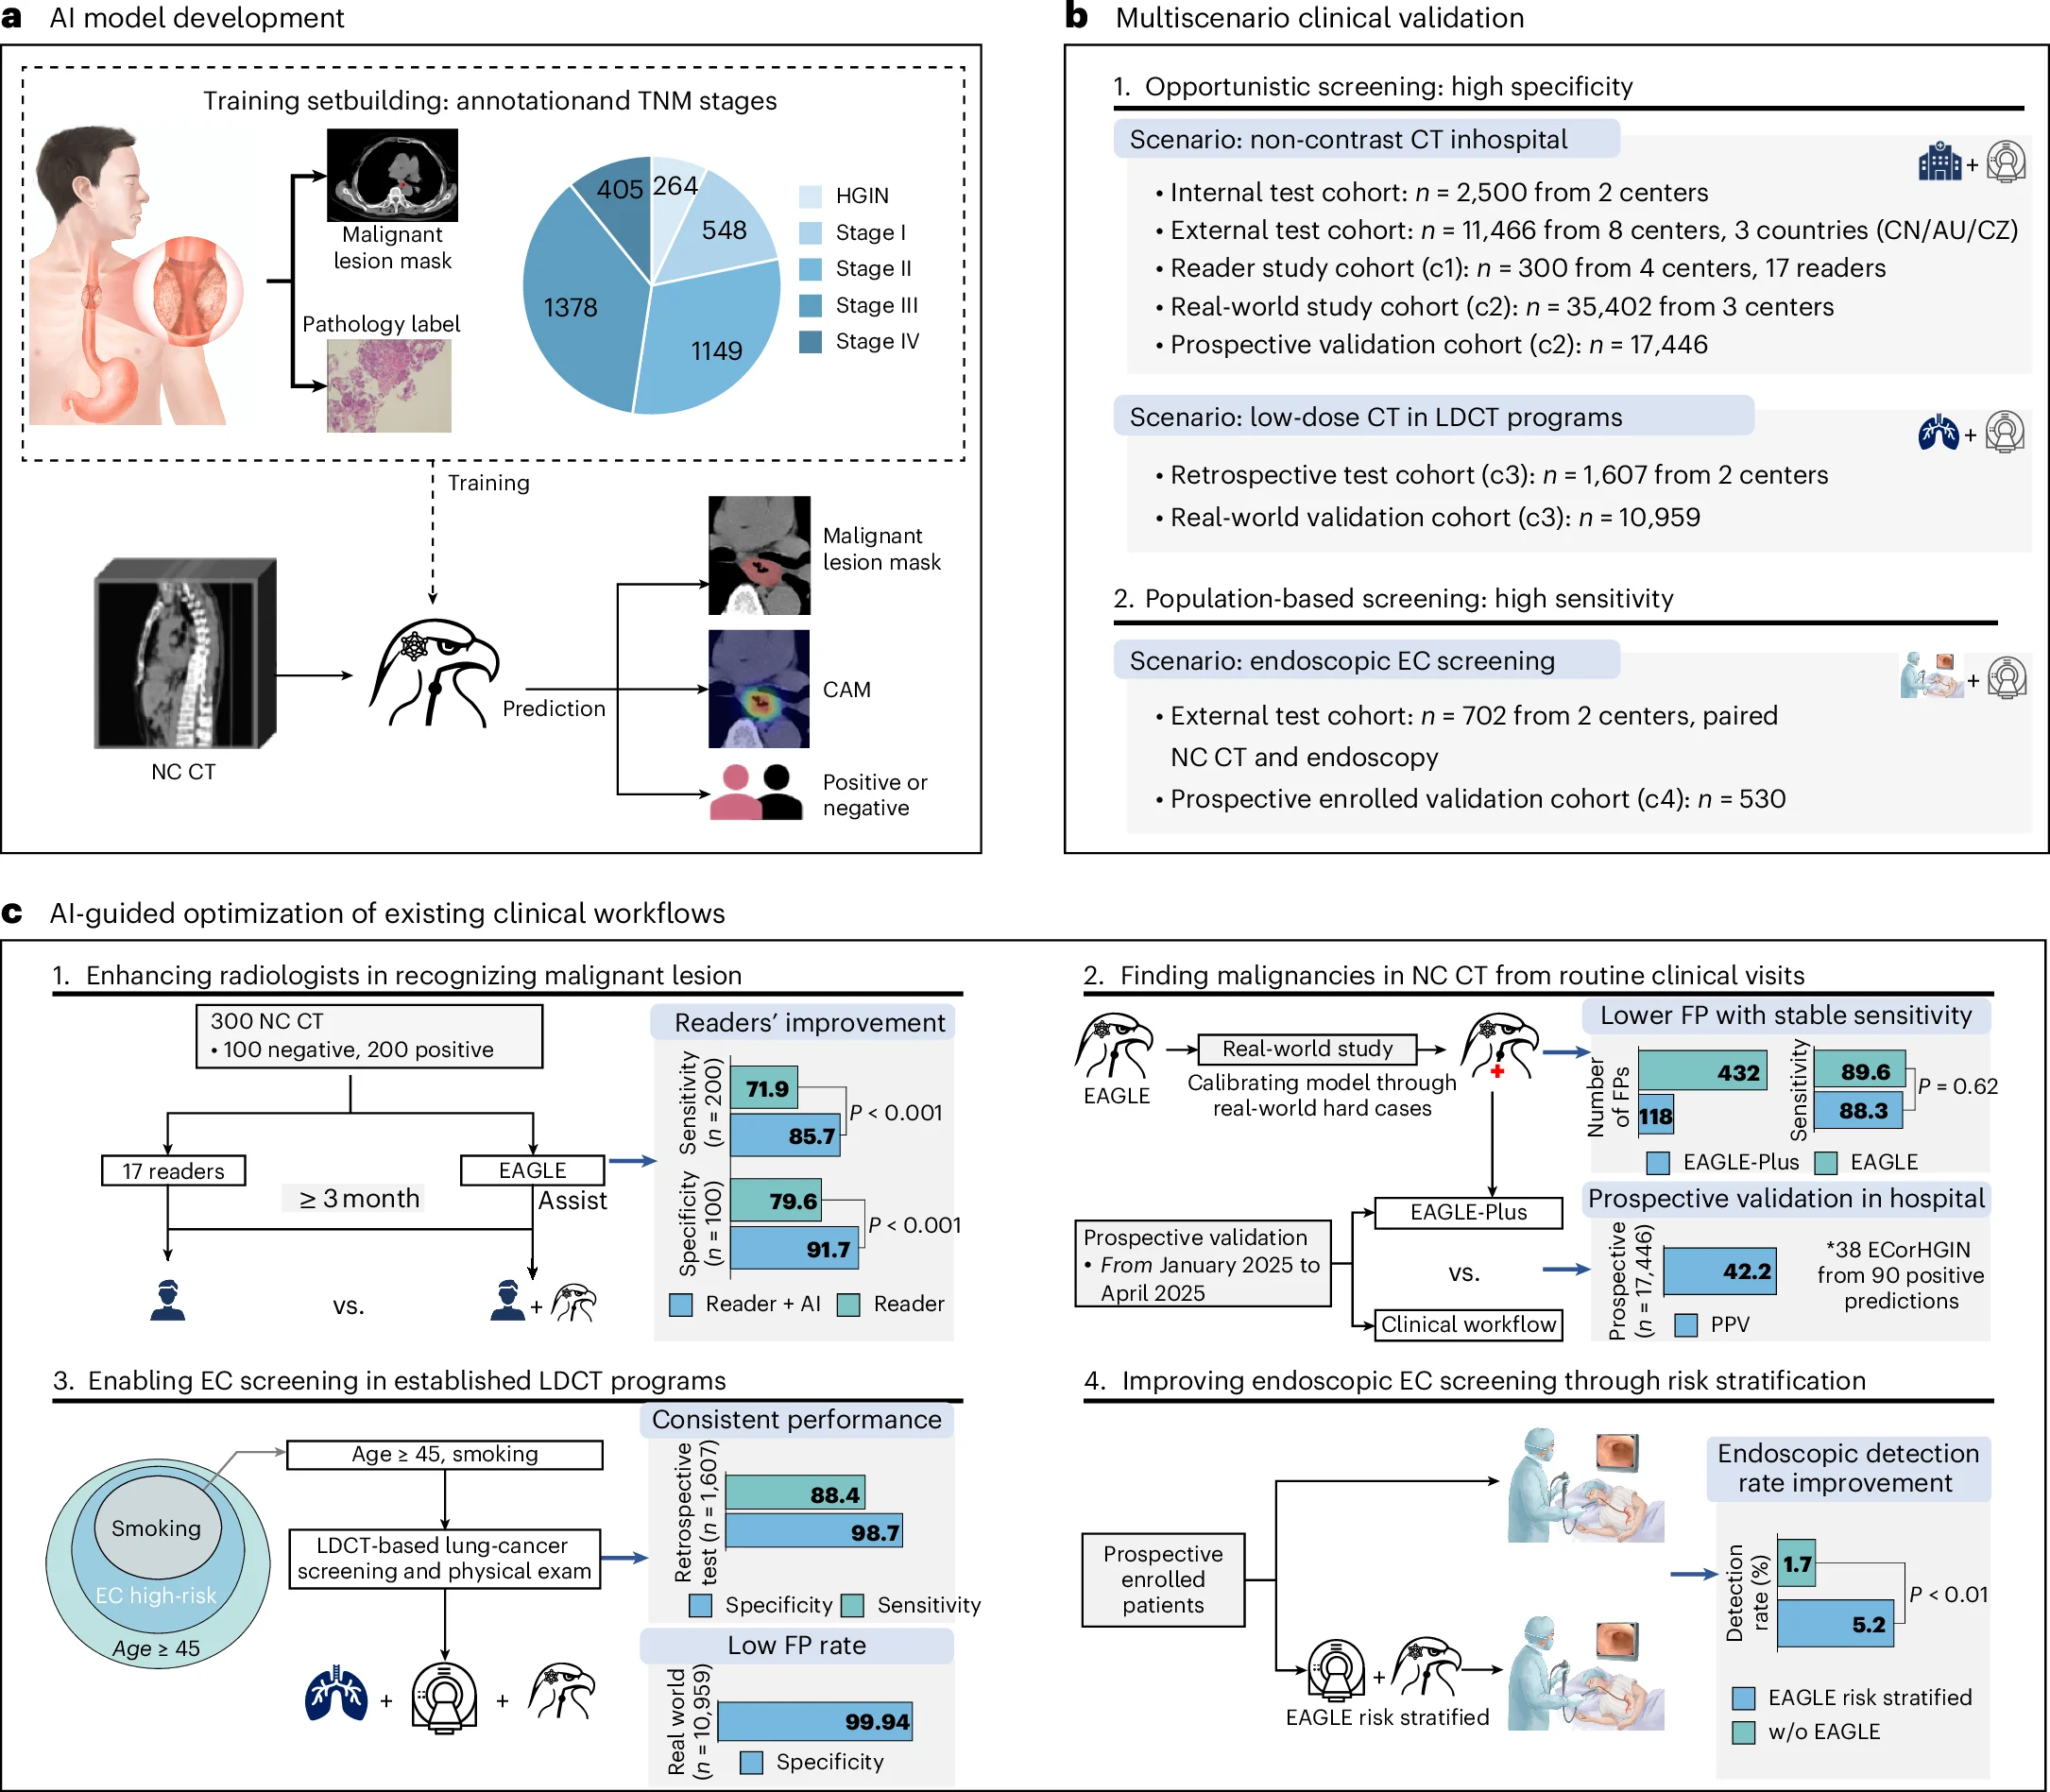
ข้อจำกัด: จากผลบวก 90 ราย ยืนยันมะเร็งหรือรอยโรคก่อนมะเร็งระดับสูง 38 ราย จึงมีค่าทำนายผลบวก (PPV) 42.2% ซึ่งไม่ใช่ความแม่นยำรวม ระบบเหมาะเป็นตัวช่วยคัดคนไปประเมินหรือส่องกล้องต่อ และยังไม่ได้พิสูจน์ว่าลดการเสียชีวิต
3. AI สำหรับทารก: ส่งโมเดลไปเรียนรู้แทนการรวมข้อมูล
งานใน Nature Biomedical Engineering ปรับ AI ของผู้ใหญ่ให้ระบุปลายท่อช่วยหายใจและจุดแยกหลอดลมในภาพทารก โดยให้โมเดลเรียนรู้ต่อเนื่องข้ามโรงพยาบาล ใช้ภาพย้อนหลัง 2,965 ภาพจาก 30 แห่งใน 20 ประเทศและดินแดน ภาพที่ 3 แสดงตัวอย่างตำแหน่งที่โมเดลระบุเทียบกับจุดอ้างอิงจากผู้เชี่ยวชาญ [3]
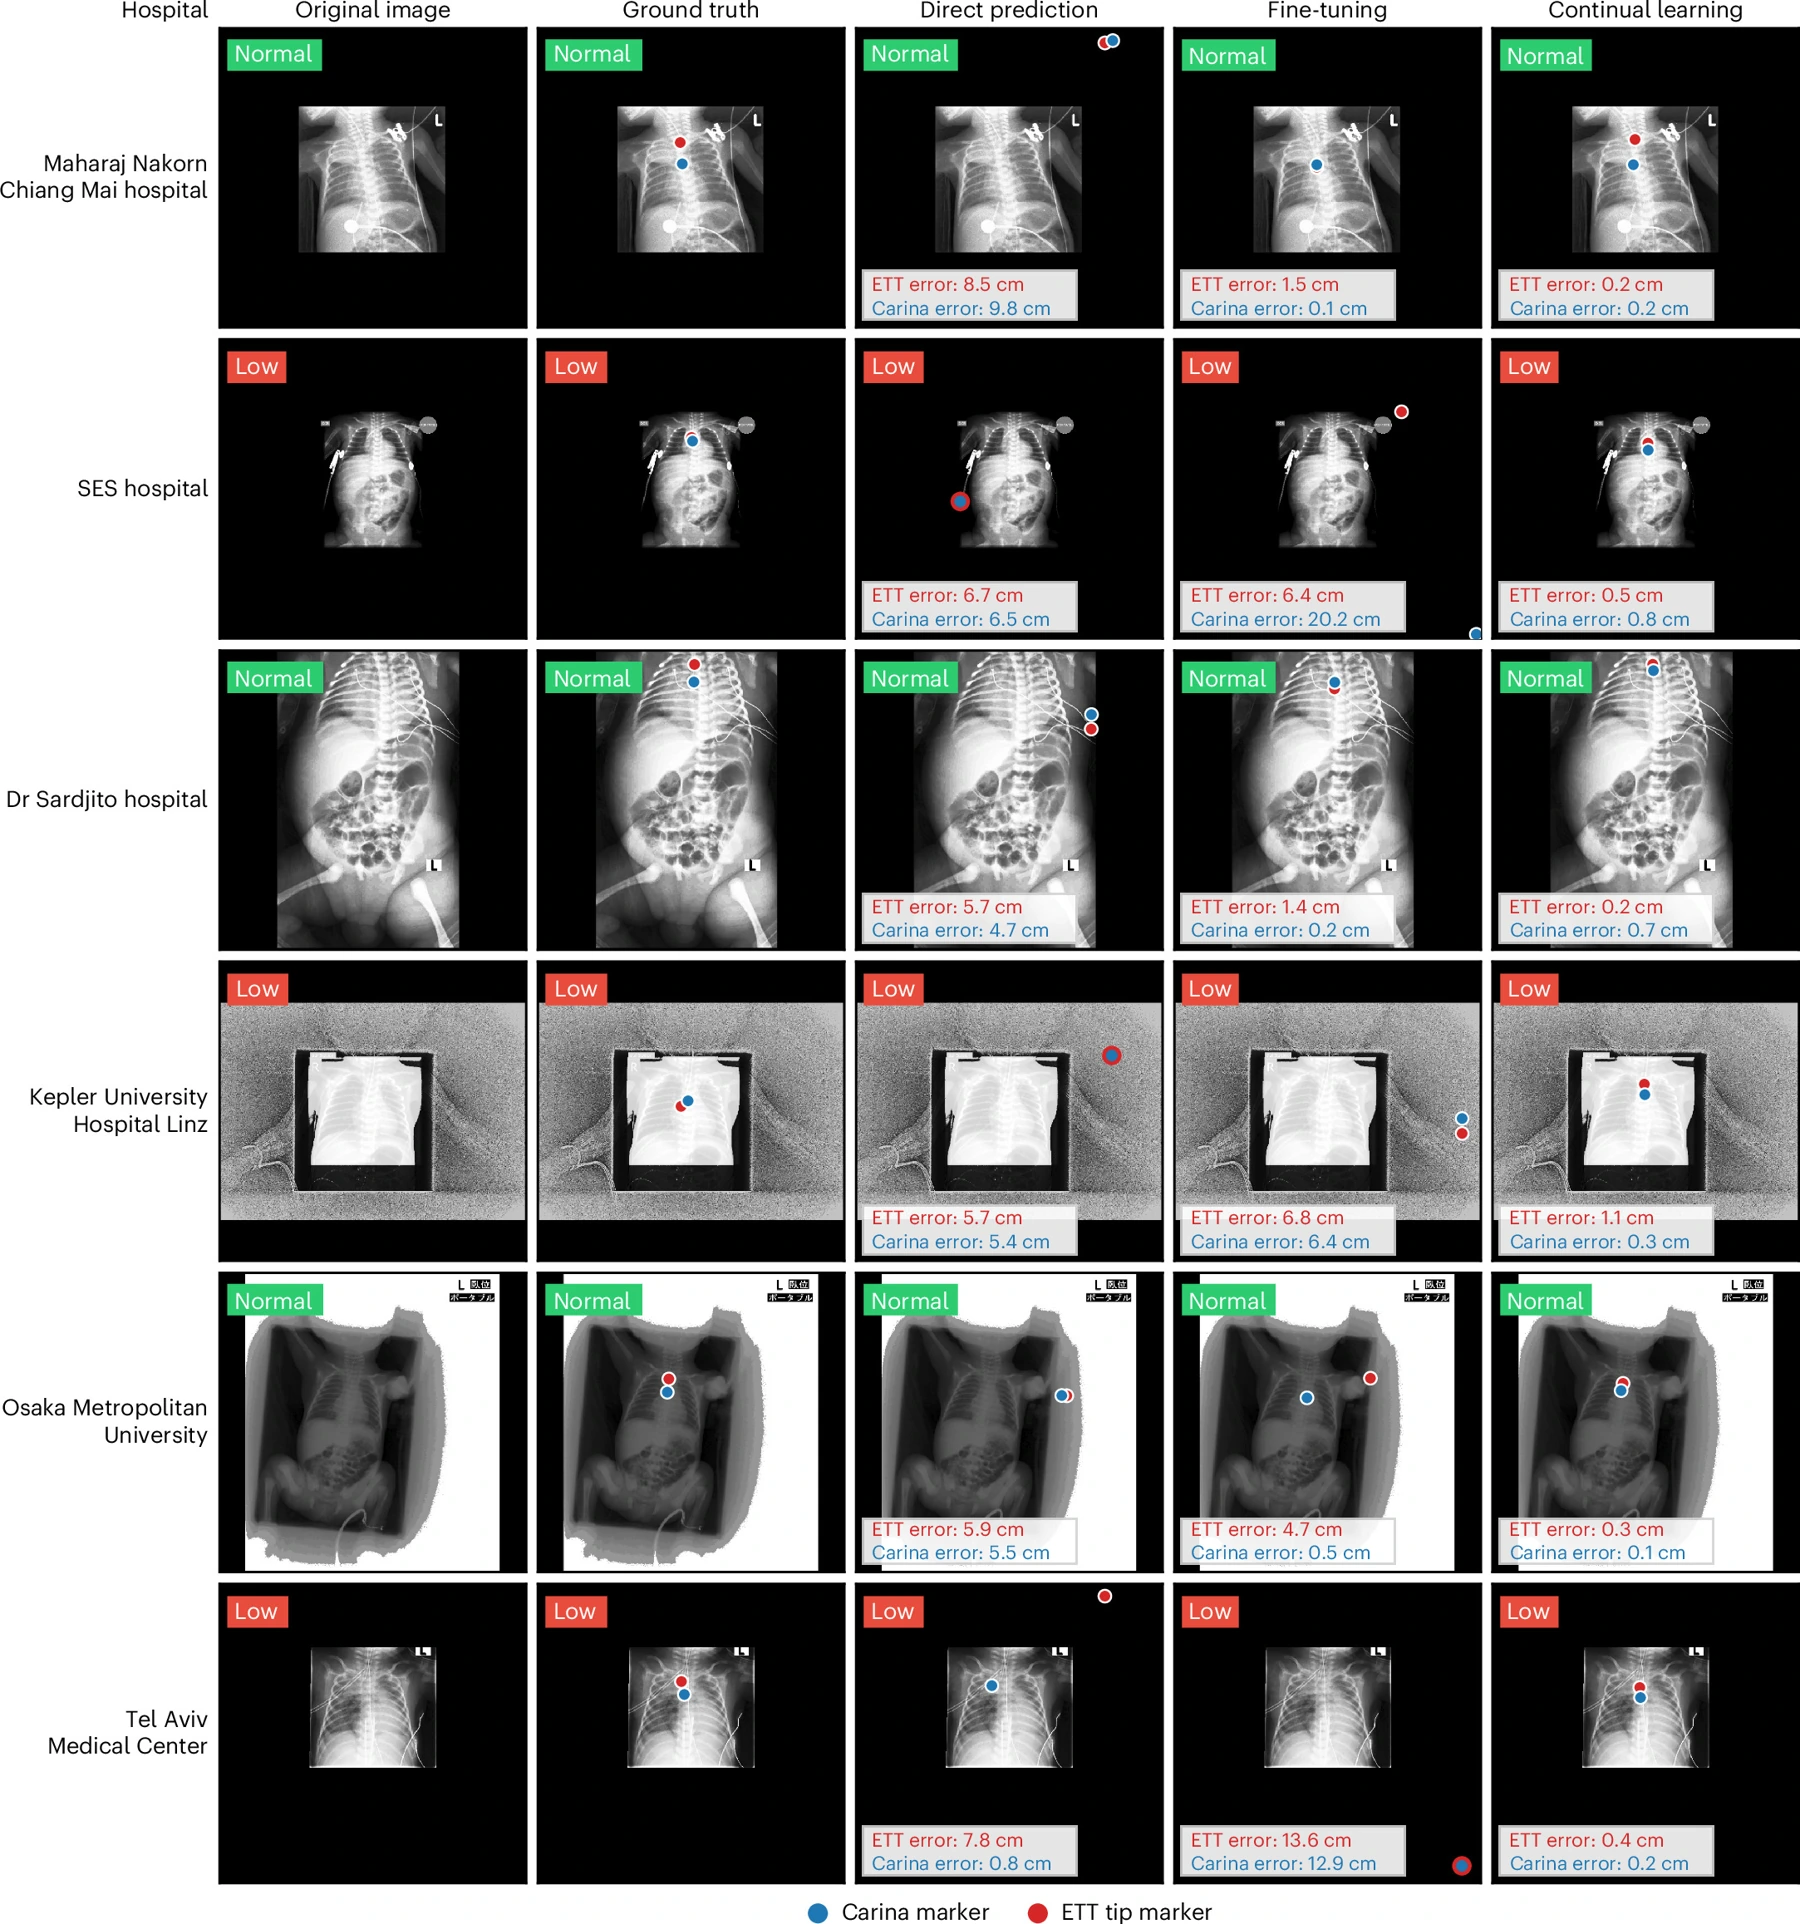
ผลและข้อจำกัด: ค่าความคลาดเคลื่อนรวมของสองตำแหน่งลดเหลือ 0.67 ซม. เทียบกับ 1.29 ซม. เมื่อฝึกในโรงพยาบาลเดียว และ 4.30 ซม. เมื่อใช้โมเดลผู้ใหญ่เดิม ผลดีขึ้นใน 29 จาก 30 แห่ง แต่ยังต้องพิสูจน์ว่าช่วยยืนยันตำแหน่งท่อเร็วขึ้นหรือลดภาวะแทรกซ้อนจริง
4. AMIE: ซักประวัติก่อนพบแพทย์
ทีม Beth Israel Deaconess Medical Center ร่วมกับ Google ให้ผู้ป่วยคุยกับ AMIE จากบ้านก่อนนัดตรวจปฐมภูมิแบบเร่งด่วน โดยมีแพทย์เฝ้าดูทุกบทสนทนาแบบเรียลไทม์ตามภาพที่ 4 งานใน The Lancet มี 98 รายทำครบ ไม่ต้องหยุดบทสนทนาด้วยเหตุความปลอดภัย แต่พบการให้ข้อมูลผิด 1 ครั้ง และต้องเสริมข้อมูลทางคลินิก 5 ครั้ง [4]
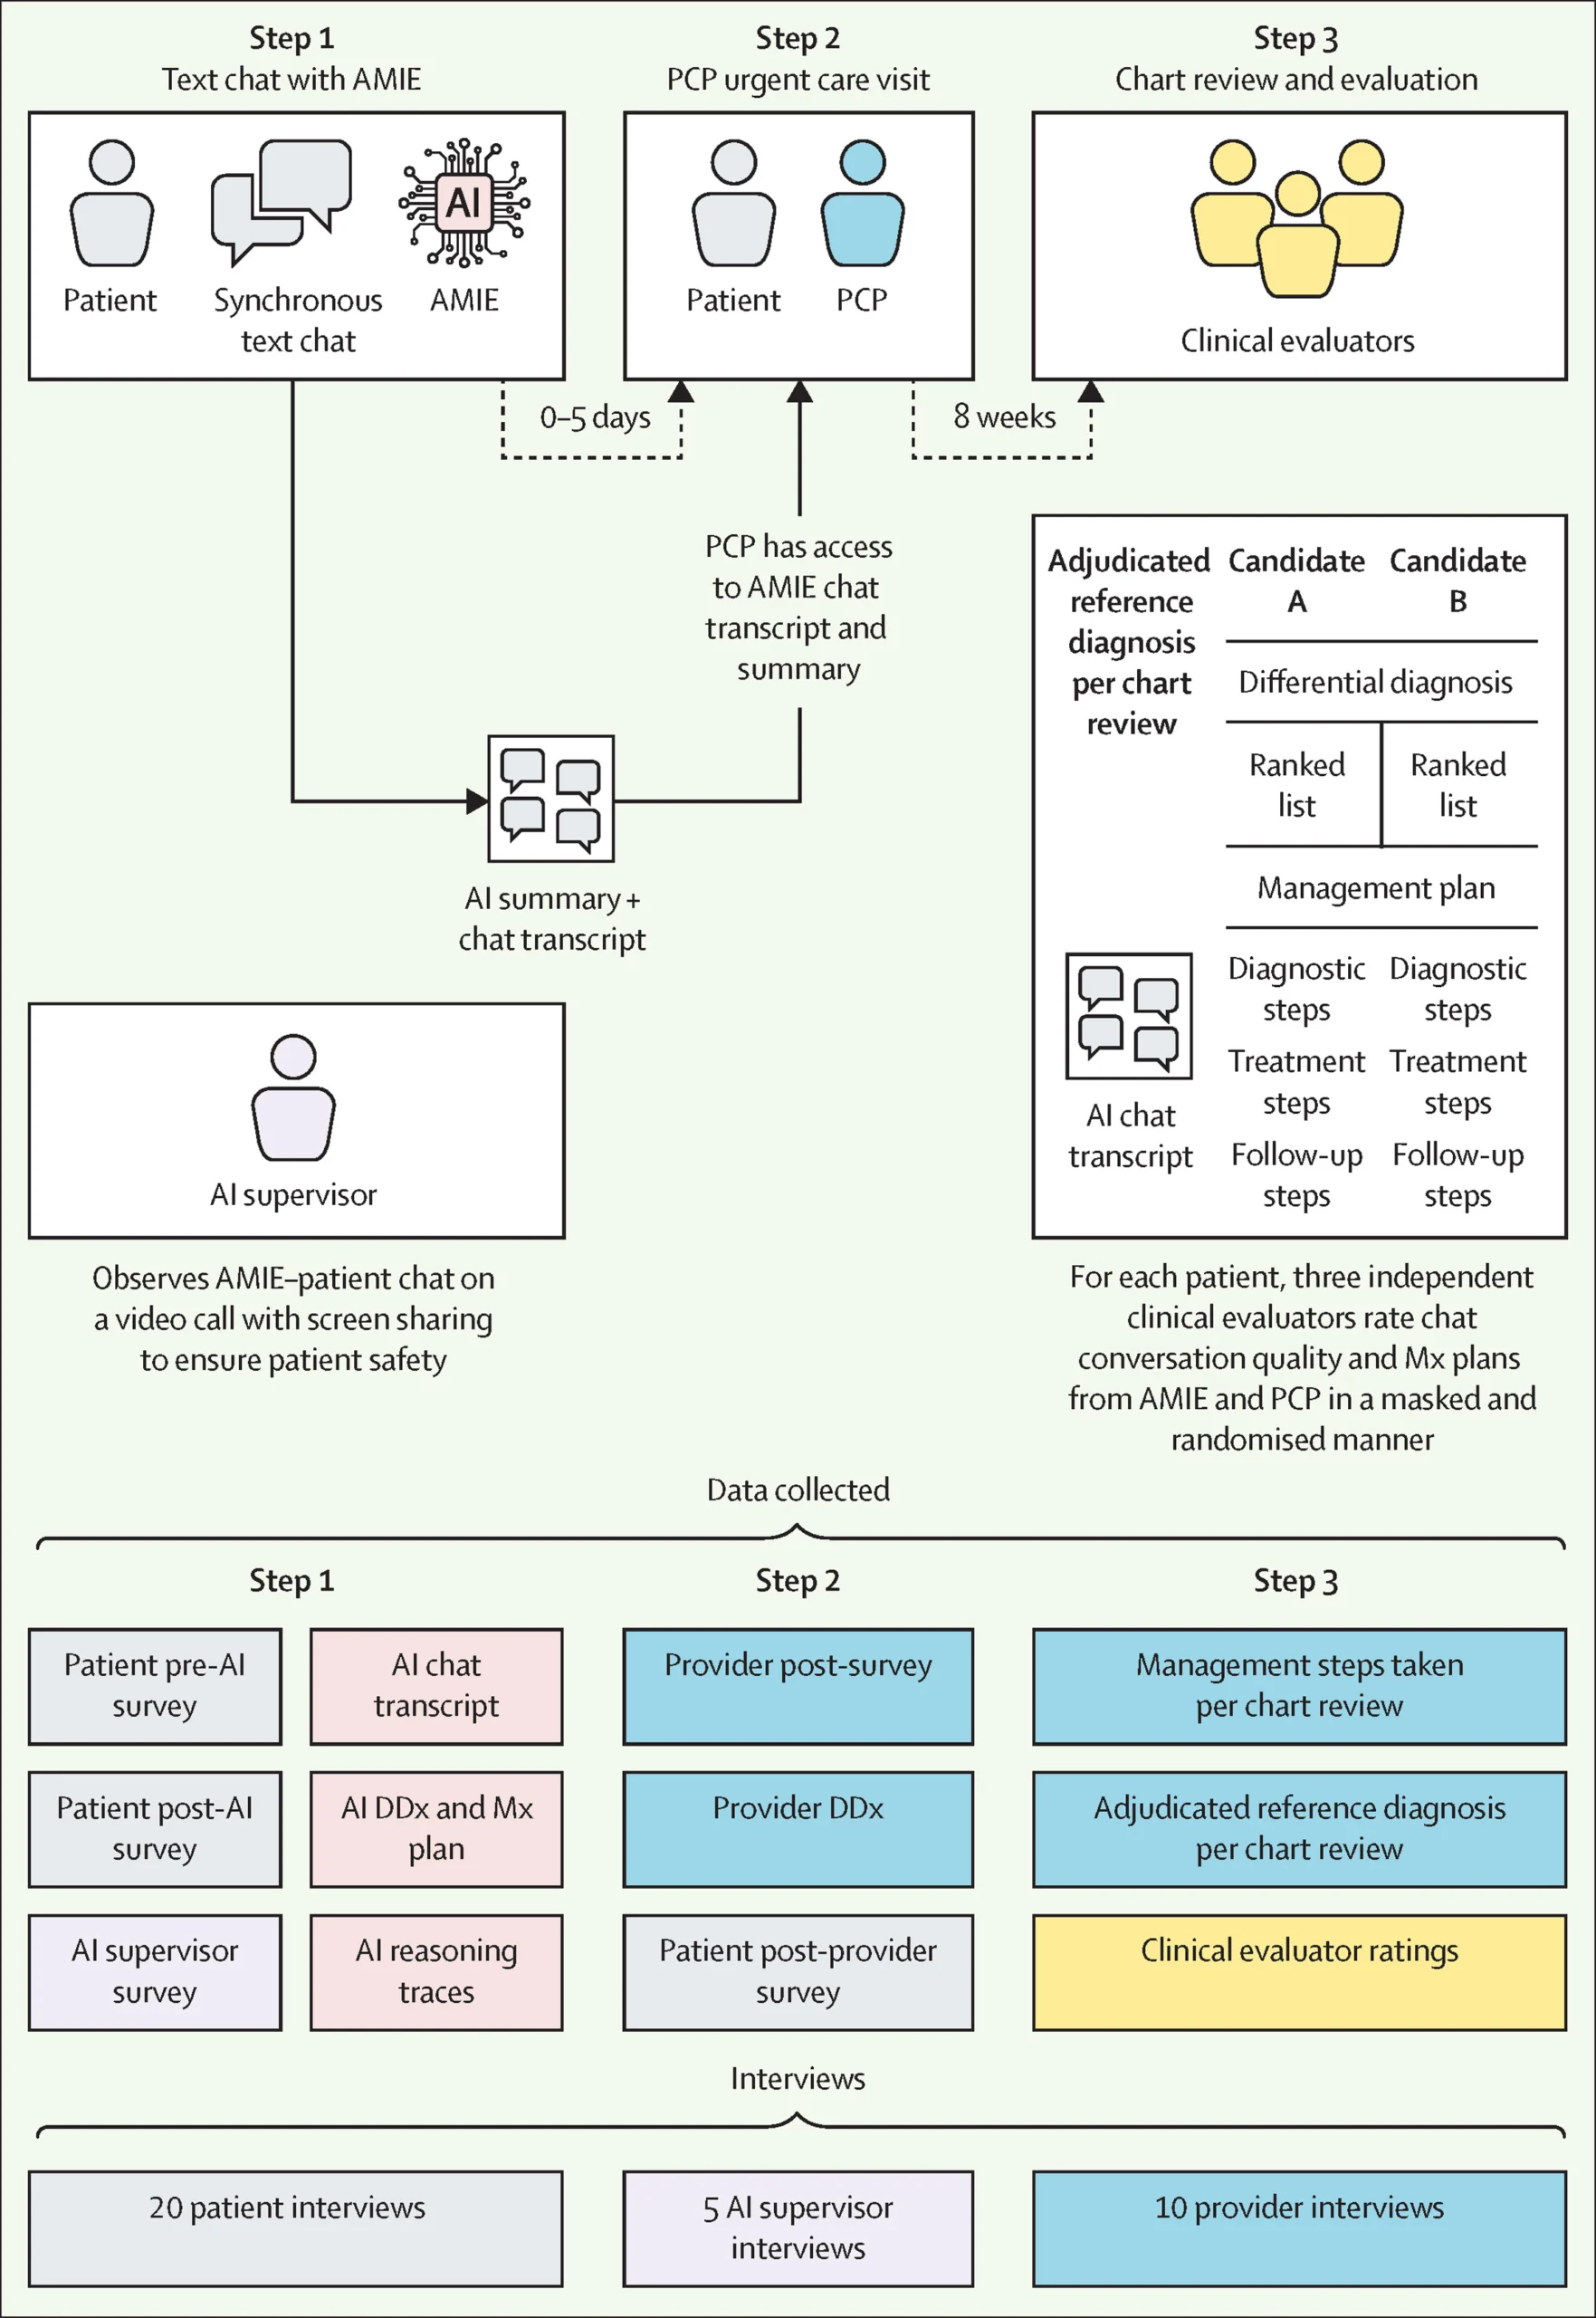
ข้อจำกัด: เป็นการศึกษาความเป็นไปได้ขนาดเล็กในศูนย์เดียว ภายใต้การกำกับของแพทย์และได้รับทุน Alphabet ผลจึงยังไม่รองรับการใช้แชตบอตลำพัง และไม่ได้พิสูจน์ว่าลดภาระงานหรือทำให้ผลการรักษาดีขึ้น
5. OpenEvidence: ใช้ค้นแนวทางรักษามากกว่าวินิจฉัย
งานใน JAMA วิเคราะห์บุคลากรสหรัฐฯ 952,008 คน รวมคำถาม 271 ล้านครั้ง ระหว่างมกราคม 2024–มิถุนายน 2026 การจำแนกตัวอย่างคำถามพบว่าเรื่องการรักษาและจัดการผู้ป่วยมากกว่าการวินิจฉัย ดังภาพที่ 5 สะท้อนบทบาท AI ในการค้นข้อมูลประกอบการดูแล [5]
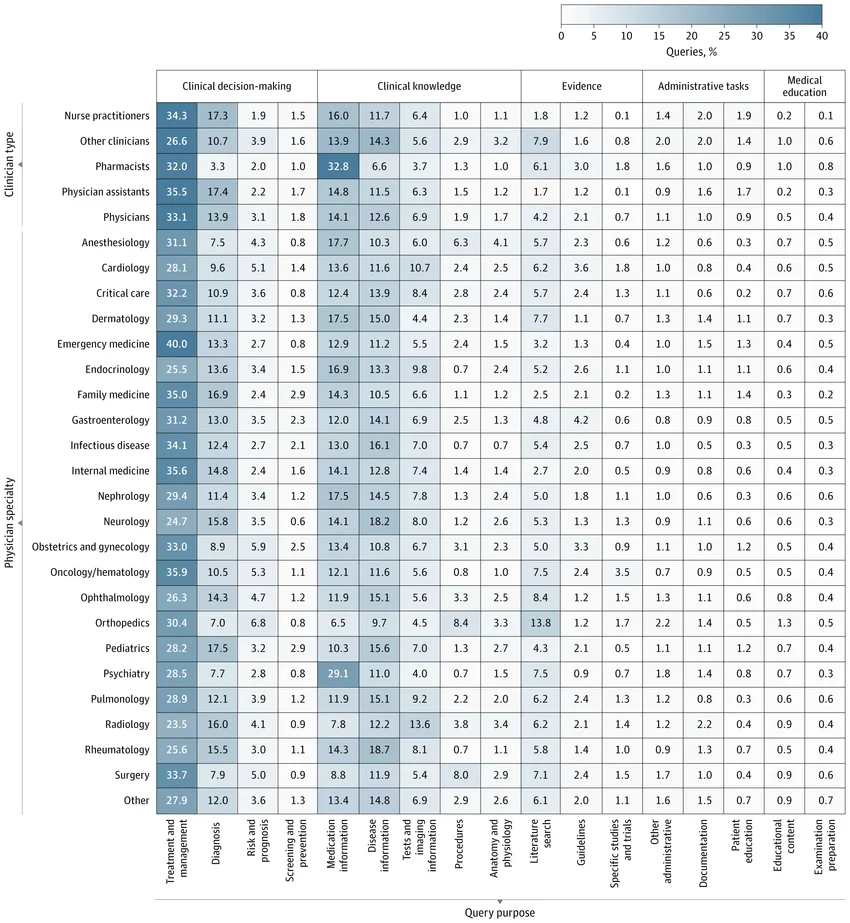
ข้อจำกัด: ข้อมูลมาจากแพลตฟอร์มเดียว ไม่ได้วัดความถูกต้องของคำตอบหรือผลต่อผู้ป่วย และผู้ร่วมวิจัย 3 คนเป็นพนักงาน OpenEvidence การมีคนใช้มากจึงยังไม่ใช่หลักฐานว่ารักษาได้ดีขึ้น
สิ่งที่ต้องพิสูจน์ต่อ
ทั้ง 5 งานวัดคนละโจทย์ จึงนำเปอร์เซ็นต์มาจัดอันดับ AI โดยตรงไม่ได้ ขั้นต่อไปคือทดสอบกับประชากรและโรงพยาบาลที่ต่างออกไป รวมถึงบริบทไทย พร้อมวัดผลบวกลวง โรคที่พลาด เวลา ภาระงาน และผลต่อผู้ป่วย เช่นเดียวกับการประเมินเครื่องมือแพทย์หรือหุ่นยนต์ช่วยผ่าตัดอื่น ๆ
อ้างอิง
- [1] Nori H, et al. Sequential diagnosis with language models. Science. 2026. สรุปผลจาก Microsoft AI. ภาพ Figure 2 จาก Science ผ่านข่าวที่เผยแพร่ภาพต้นฉบับ.
- [2] Zhou J, et al. Large-scale esophageal cancer screening through noncontrast computed tomography and artificial intelligence. Nat Med. 2026;32:3748–3759. ภาพ Figure 1 จากต้นฉบับ ภายใต้ CC BY-NC-ND 4.0.
- [3] Rao VM, et al. Repurposing adult AI radiograph models for neonatal care through continual learning: an international multicentre study. Nat Biomed Eng. 2026. ภาพเอกซเรย์จาก Figure 2 ใช้ตาม CC BY 4.0; ปรับขนาดและบีบอัดโดยไม่เปลี่ยนข้อมูล.
- [4] Brodeur PG, et al. Conversational diagnostic artificial intelligence in ambulatory primary care: a prospective feasibility study. Lancet. 2026.
- [5] Patel VR, et al. Clinician Use of an Artificial Intelligence–Enabled Clinical Information Platform. JAMA. 2026. doi:10.1001/jama.2026.21868. ภาพ Figure 3 จากตัวอย่างบทความของผู้เผยแพร่บน ResearchGate.