
สารบัญบทความ
ฉบับปรับปรุงเนื้อหาโดย sarapuk — 13 ตุลาคม 2026 • บทความต้นฉบับโดย Temsiri Songjaroen เผยแพร่ 22 มีนาคม 2010
เมื่อเครื่องมือในห้องปฏิบัติการอ่านลำดับ DNA วัดการแสดงออกของยีน หรือเก็บข้อมูลจากเซลล์จำนวนมาก สิ่งที่ได้ยังเป็นข้อมูลที่ต้องผ่านการตรวจคุณภาพและตีความ เราจะรู้ได้อย่างไรว่าลำดับที่พบอยู่ในยีนใด เซลล์แต่ละชนิดกำลังทำอะไร หรือความแตกต่างที่เห็นเกี่ยวข้องกับโรคจริงหรือไม่ คำถามเหล่านี้เป็นงานสำคัญของ ชีวสารสนเทศศาสตร์ หรือ Bioinformatics
Bioinformatics ผสมความรู้ด้านชีววิทยา วิทยาการคอมพิวเตอร์ และสถิติ เพื่อเก็บ จัดระเบียบ วิเคราะห์ และเผยแพร่ข้อมูลชีวภาพ ตัวอย่างได้แก่ลำดับ DNA และกรดอะมิโน ตลอดจนข้อมูลที่อธิบายตำแหน่งและหน้าที่ของลำดับเหล่านั้น งานจึงครอบคลุมทั้งฐานข้อมูล เครื่องมือคำนวณ และการตีความผล ไม่ได้จำกัดอยู่ที่การเขียนโปรแกรมหรือการใช้ AI เท่านั้น [1]
แนวคิดของบทความเดิมที่ว่าคอมพิวเตอร์ช่วยจัดการข้อมูลจำนวนมากและช่วยวางแผนทดลองยังใช้ได้ แต่ผลคำนวณมีขอบเขตตามข้อมูลและแบบจำลองที่ใช้ การทำนายช่วยจัดลำดับสิ่งที่ควรตรวจต่อ ไม่ได้ยืนยันผลการทดลองล่วงหน้าเสมอไป
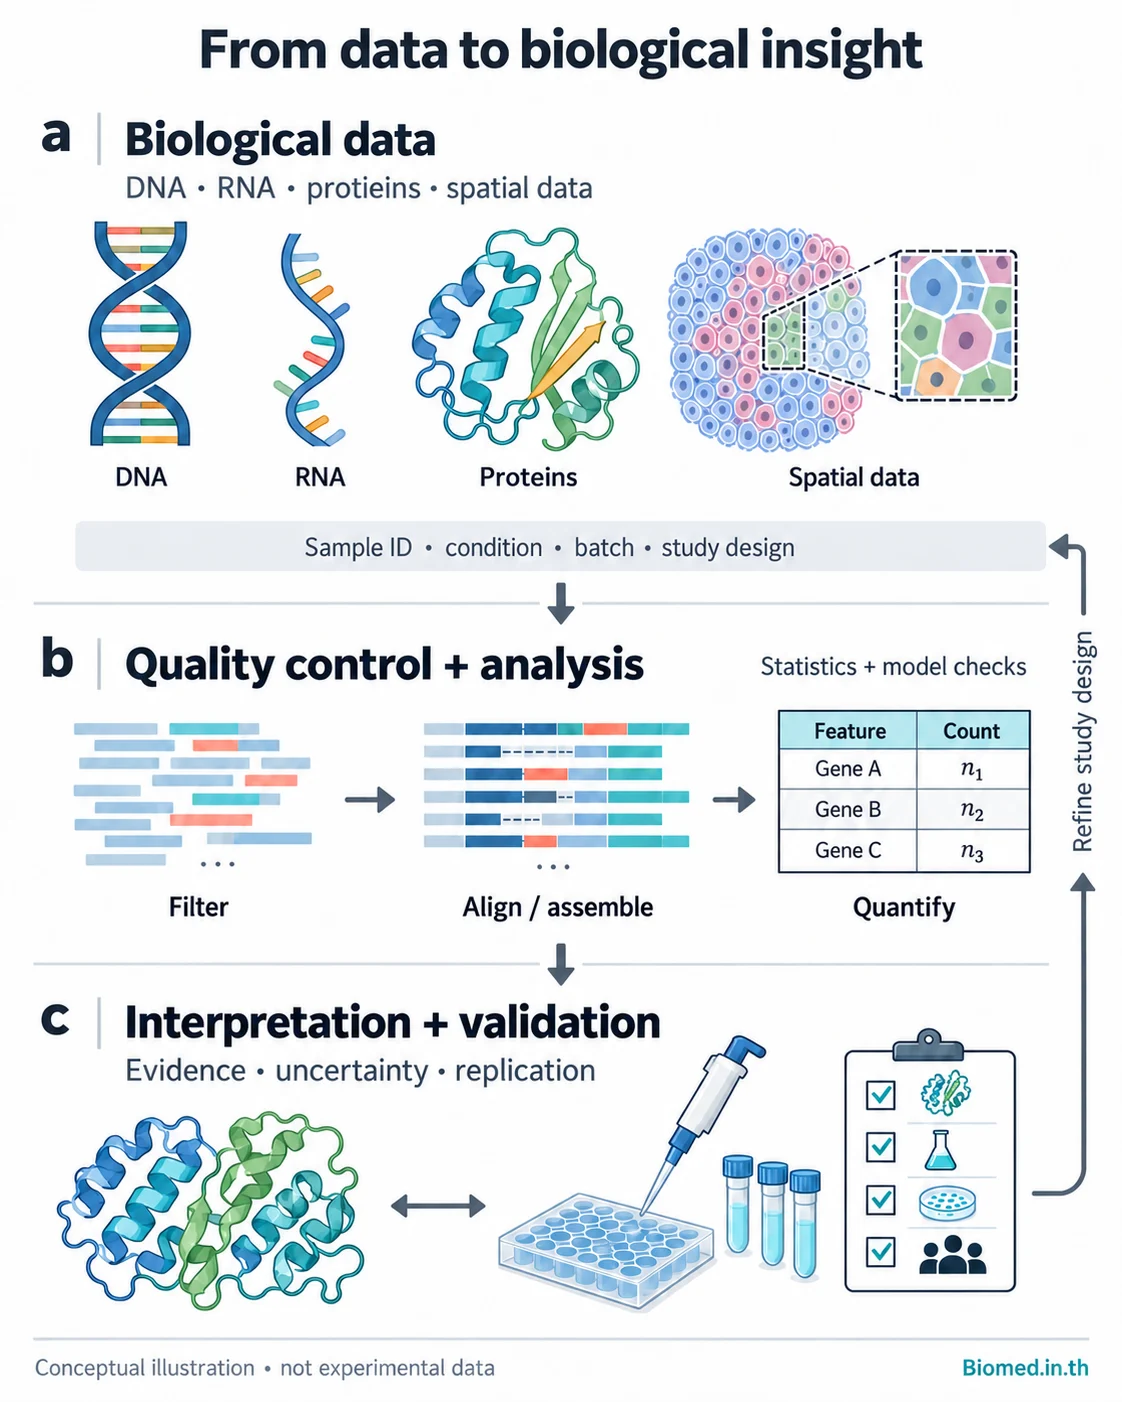
ข้อมูลที่นำมาวิเคราะห์มีอะไรบ้าง
ข้อมูลแต่ละชนิดตอบคำถามต่างกัน การเลือกวิธีวิเคราะห์จึงต้องเริ่มจากคำถามทางชีววิทยา และวิธีที่ใช้วัดข้อมูลนั้น ไม่ใช่เริ่มจากโปรแกรมที่มีอยู่เพียงอย่างเดียว [2]
| ชนิดข้อมูล | ตัวอย่างคำถาม | ข้อควรระวัง |
|---|---|---|
| จีโนม (Genomics) | ลำดับ DNA แตกต่างกันตรงไหน มีการเพิ่ม ลบ หรือสลับชิ้นส่วนหรือไม่ | ผลขึ้นกับคุณภาพการอ่านและจีโนมอ้างอิงที่ใช้ |
| ทรานสคริปโตม (Transcriptomics) | ยีนใดมี RNA มากหรือน้อยต่างกันระหว่างสภาวะ | ปริมาณ RNA ไม่เท่ากับปริมาณหรือกิจกรรมของโปรตีนโดยตรง |
| ข้อมูลระดับเซลล์เดี่ยวและเชิงพื้นที่ | เซลล์แต่ละกลุ่มมีลักษณะอย่างไร และอยู่บริเวณใดในเนื้อเยื่อ | ข้อมูลเชิงพื้นที่บางวิธีรวมหลายเซลล์ต่อจุดวัด |
| โปรตีนและโครงสร้างโมเลกุล | โปรตีนมีลำดับ หน้าที่ หรือรูปร่างสามมิติอย่างไร | ต้องแยกโครงสร้างที่วัดได้จากการทดลองกับโครงสร้างที่ทำนาย |
| ข้อมูลหลายระดับ (Multi-omics) | DNA การควบคุมยีน RNA และโปรตีนเชื่อมโยงกันอย่างไร | การรวมข้อมูลต้องคำนึงถึงตัวอย่าง วิธีวัด และความต่างระหว่างชุดข้อมูล |
Bioinformatics มีส่วนทับซ้อนกับชีววิทยาเชิงคำนวณ (Computational biology) และชีวสถิติ ในการใช้งานจริงทีมวิจัยมักทำงานร่วมกัน ตั้งแต่การออกแบบการทดลองไปจนถึงการสร้างแบบจำลองและอธิบายความไม่แน่นอน เส้นแบ่งระหว่างสาขาจึงไม่ได้ตายตัว
ตัวอย่างงานหนึ่งชิ้น: เปรียบเทียบการแสดงออกของยีน
สมมติว่าเราต้องการทราบว่าเซลล์หลังได้รับสารทดลองมีการตอบสนองต่างจากกลุ่มควบคุมอย่างไร การวิเคราะห์ RNA sequencing หรือ RNA-seq เป็นตัวอย่างที่ช่วยให้เห็นกระบวนการทำงานได้ชัดเจน โดยรายละเอียดต้องปรับตามการทดลองและชนิดข้อมูล [3]
- ออกแบบการทดลองและบันทึกข้อมูลตัวอย่าง ระบุเงื่อนไข กลุ่มควบคุม ตัวอย่างซ้ำทางชีวภาพ และปัจจัยที่อาจรบกวนผล เช่น วันเตรียมตัวอย่างหรือรอบการวัด หากทุกตัวอย่างกลุ่มทดลองอยู่คนละรอบกับกลุ่มควบคุม ความต่างจากรอบการวัดอาจแยกจากผลของสารทดลองไม่ได้
- ตรวจคุณภาพข้อมูลดิบ พิจารณาคุณภาพลำดับที่อ่านได้ การปนเปื้อน และข้อมูลที่ผิดปกติ สำหรับข้อมูลเซลล์เดี่ยวต้องพิจารณาเซลล์คุณภาพต่ำ RNA จากพื้นหลัง และกรณีที่ระบบจับเซลล์มากกว่าหนึ่งเซลล์ร่วมกันด้วย
- แปลงข้อมูลเป็นค่าที่วิเคราะห์ได้ ใช้วิธีจับคู่ลำดับกับจีโนมหรือทรานสคริปต์อ้างอิง หรือวิธีประมาณปริมาณที่เหมาะสม เพื่อสร้างข้อมูลระดับยีนหรือทรานสคริปต์ การเลือกอ้างอิงและคำอธิบายยีนมีผลต่อผลลัพธ์
- วิเคราะห์ความแตกต่างด้วยสถิติ ใช้แบบจำลองที่เหมาะกับชนิดข้อมูลและการออกแบบการทดลอง พร้อมควบคุมปัญหาการทดสอบยีนจำนวนมาก พิจารณาทั้งขนาดความแตกต่าง ความไม่แน่นอน และอัตราการค้นพบผิด (False discovery rate; FDR)
- ตีความและทดสอบต่อ ตรวจว่าผลสอดคล้องกับชีววิทยาและหลักฐานอื่นหรือไม่ อาจตรวจยีนที่สนใจด้วยวิธีอิสระ หรือทดลองหน้าที่ของยีนนั้น ผลที่พบควรนำไปตั้งสมมติฐานต่ออย่างมีเหตุผล
ตัวอย่างข้างต้นเป็นลำดับงานเพื่ออธิบายหลักคิด ไม่ใช่สูตรวิเคราะห์ที่ใช้ได้กับทุกชุดข้อมูล โดยเฉพาะข้อมูลเซลล์เดี่ยว วิธีรวมชุดข้อมูล การจัดกลุ่ม และการทดสอบความแตกต่างมีข้อสมมติของตนเอง ต้องพิจารณาว่าหน่วยตัวอย่างอิสระเป็นผู้บริจาค สัตว์ทดลอง หรือการเพาะเลี้ยง ไม่ควรนับเซลล์จำนวนมากจากผู้บริจาคคนเดียวเสมือนเป็นผู้บริจาคจำนวนมาก [3]
ฐานข้อมูลและเครื่องมือทำหน้าที่ต่างกันอย่างไร
ฐานข้อมูลช่วยให้ข้อมูลค้นหาและเชื่อมโยงกันได้ ส่วนเครื่องมือใช้คำนวณหรือแสดงผลจากข้อมูลนั้น ตัวอย่างเช่น Ensembl ใช้สำรวจจีโนมและคำอธิบายยีน UniProt ใช้ค้นข้อมูลลำดับและหน้าที่ของโปรตีน และทรัพยากรอย่าง PDBe เชื่อมโยงข้อมูลโครงสร้างโมเลกุลจาก PDB สำหรับโครงสร้างที่ทำนายด้วย AI มี AlphaFold Protein Structure Database ซึ่งต้องอ่านพร้อมค่าความเชื่อมั่นและข้อจำกัดของแบบจำลอง [2]
เครื่องมือค้นความคล้ายของลำดับ เช่น BLAST เปรียบเทียบลำดับ DNA หรือโปรตีนที่เราสนใจกับข้อมูลในฐานข้อมูล เพื่อหาบริเวณที่คล้ายกัน ความคล้ายช่วยตั้งข้อสันนิษฐานเกี่ยวกับความสัมพันธ์หรือหน้าที่ แต่ต้องดูความยาวที่จับคู่ ความครอบคลุม นัยสำคัญของการจับคู่ และหลักฐานประกอบก่อนสรุปหน้าที่ของยีน [4]
ในการรายงานผลควรเก็บรหัสรายการข้อมูล (Accession) รุ่นของฐานข้อมูลหรือวันที่เข้าถึง รุ่นจีโนมอ้างอิง และรุ่นคำอธิบายยีนไว้ด้วย เพื่อให้ผู้อื่นตรวจสอบได้ว่าใช้ข้อมูลชุดใด การใช้ชื่อยีนเพียงอย่างเดียวอาจไม่เพียงพอเมื่อรายการหรือคำอธิบายถูกปรับปรุง
พัฒนาการสำคัญ: จากจีโนมอ้างอิงเส้นเดียวสู่ Pangenome
การเทียบลำดับกับจีโนมอ้างอิงช่วยให้ระบุตำแหน่งและเปรียบเทียบข้อมูลระหว่างงานได้ แต่จีโนมอ้างอิงเส้นตรงหนึ่งชุดไม่สามารถแทนความหลากหลายของมนุษย์ทั้งหมดได้ แนวคิด แพนจีโนม (Pangenome) จึงรวบรวมลำดับจากหลายจีโนม และอาจใช้กราฟแสดงเส้นทางลำดับทางเลือก แทนการบังคับให้ข้อมูลทั้งหมดเทียบกับเส้นทางเดียว [5]
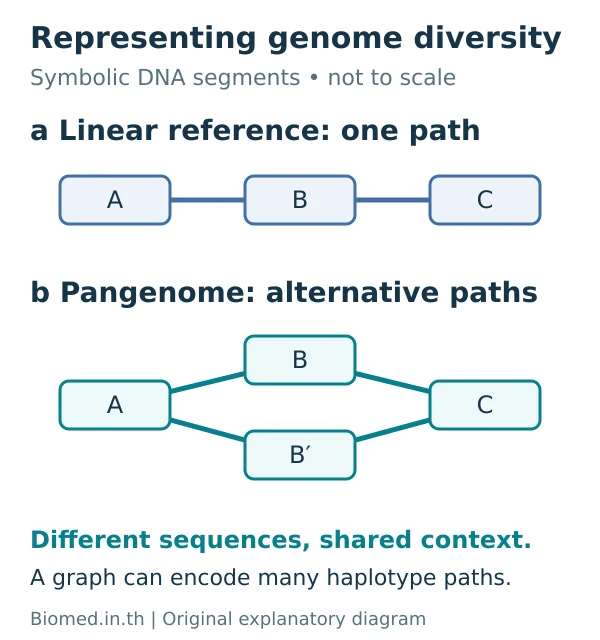
งานของ Liao และคณะในปี 2023 เสนอร่างจีโนมอ้างอิงมนุษย์แบบ pangenome ส่วนงานของ Logsdon และคณะในปี 2025 อ่านและประกอบจีโนมมนุษย์ที่มีความหลากหลาย 65 ราย ได้ลำดับที่แยกตามแฮโพลไทป์ 130 ชุด ช่วยศึกษาบริเวณซับซ้อนและความแปรผันเชิงโครงสร้างที่การอ้างอิงแบบเดิมจัดการได้ยาก ตัวเลขนี้หมายถึงขนาดชุดข้อมูลของงานวิจัยดังกล่าว ไม่ใช่จำนวนจีโนมทั้งหมดที่มีอยู่ในฐานข้อมูลปัจจุบัน [5][6]
ข้อจำกัดยังมีทั้งความครอบคลุมประชากร ความซับซ้อนของกราฟ และการปรับเครื่องมือวิเคราะห์ให้รองรับข้อมูล การแทนความหลากหลายได้ดีขึ้นไม่ได้หมายความว่าความแปรผันทุกตำแหน่งได้รับการอธิบายผลต่อสุขภาพแล้ว
ข้อมูลเซลล์เดี่ยวและเชิงพื้นที่เพิ่มคำถามแบบใหม่
การวัดจากเนื้อเยื่อรวมอาจซ่อนความต่างระหว่างเซลล์ การวิเคราะห์ระดับเซลล์เดี่ยวช่วยมองเห็นกลุ่มเซลล์และสภาวะของเซลล์ ขณะที่ข้อมูลเชิงพื้นที่ช่วยเชื่อมผลโมเลกุลกับตำแหน่งในเนื้อเยื่อ การรวมหลายชนิดข้อมูลอาจช่วยอธิบายได้ว่าเซลล์ใดมีการควบคุมยีนแบบใด และเกี่ยวข้องกับสภาพแวดล้อมรอบตัวอย่างไร [3]
อย่างไรก็ตาม จุดที่อยู่ใกล้กันในภาพลดมิติ เช่น UMAP ไม่ใช่หลักฐานโดยลำพังว่าเซลล์มีสายพัฒนาการต่อกัน และกลุ่มที่โปรแกรมแบ่งให้ไม่จำเป็นต้องเป็นชนิดเซลล์ใหม่ ต้องตรวจยีนบ่งชี้ การออกแบบการทดลอง และหลักฐานอิสระประกอบด้วย [13]
AI ช่วยทำนายโครงสร้าง แต่ยังต้องตรวจหลักฐาน
งาน AlphaFold 3 ของ Abramson และคณะในปี 2024 แสดงแบบจำลองที่ทำนายโครงสร้างร่วมของโปรตีน กรดนิวคลีอิก โมเลกุลขนาดเล็ก และองค์ประกอบอื่นได้ นี่เป็นตัวอย่างว่า Bioinformatics ไม่ได้หยุดที่การจัดเก็บลำดับ แต่ใช้ข้อมูลและแบบจำลองเพื่อเสนอภาพความสัมพันธ์ระดับโมเลกุลด้วย [7]
รูปร่างที่ทำนายได้ยังต้องตรวจคุณภาพ แบบจำลองอาจจัดอะตอมผิด ให้โครงสร้างที่ดูมีระเบียบในบริเวณที่จริงไม่เป็นระเบียบ หรือไม่สะท้อนการเคลื่อนไหวและหลายสภาวะของโมเลกุล การทำนายตำแหน่งจับของสารจึงไม่ใช่หลักฐานโดยตรงว่าสารนั้นจับจริง มีฤทธิ์รักษา หรือปลอดภัยในมนุษย์ [8]
ผลวิเคราะห์ที่น่าเชื่อถือต้องผ่านอะไรบ้าง
ความน่าเชื่อถือเริ่มจากข้อมูลและคำถามที่เหมาะสม ไม่ใช่กราฟที่ดูสวย ควรตรวจผลจากวิธีเตรียมตัวอย่าง ความต่างระหว่างรอบการวัด (Batch effect) ตัวแปรกวน และการเลือกค่าพารามิเตอร์ หากสร้างโมเดลทำนาย ต้องแยกข้อมูลฝึกและข้อมูลทดสอบอย่างเหมาะสม ไม่ให้ข้อมูลของบุคคลหรือชุดตัวอย่างเดียวกันรั่วไปทั้งสองฝั่ง และควรทดสอบกับข้อมูลอิสระที่สอดคล้องกับบริบทการใช้งาน
สำหรับการแปลผลความแปรผันของยีนที่เกี่ยวกับโรคแบบเมนเดล กรอบ ACMG/AMP ปี 2015 แยกผลเป็นก่อโรค น่าจะก่อโรค ความหมายยังไม่แน่ชัด น่าจะไม่ก่อโรค และไม่ก่อโรค โดยใช้หลักฐานหลายชนิดร่วมกัน คะแนนจากโปรแกรมเป็นเพียงส่วนหนึ่งของหลักฐาน ไม่ได้แทนการประเมินทางคลินิก และต้องพิจารณาคำแนะนำเพิ่มเติมหรือเกณฑ์เฉพาะยีนที่เกี่ยวข้องจาก ClinGen [9][10]
ความสามารถในการทำซ้ำก็สำคัญ ควรบันทึกชุดข้อมูล โค้ด รุ่นซอฟต์แวร์ พารามิเตอร์ และสภาพแวดล้อมที่ใช้ หลัก FAIR เสนอให้ข้อมูลค้นหาได้ เข้าถึงได้ ทำงานร่วมกันได้ และนำกลับมาใช้ได้ โดยการเข้าถึงอาจมีการยืนยันตัวตนหรือข้อจำกัดตามสิทธิ์ จึงไม่ได้หมายถึงเปิดข้อมูลจีโนมของทุกคนต่อสาธารณะ [11]
เริ่มเรียน Bioinformatics ได้อย่างไร
ผู้เริ่มต้นควรฝึกอ่านข้อมูลจากคำถามเล็ก ๆ ก่อน เช่น ค้นโปรตีนหนึ่งตัวใน UniProt สำรวจตำแหน่งยีนใน Ensembl หรือใช้ BLAST เปรียบเทียบลำดับที่ทราบที่มา แล้วอธิบายว่าผลตอบคำถามใดและยังตอบอะไรไม่ได้ เมื่อเริ่มทำงานกับข้อมูลจำนวนมากจึงค่อยเพิ่มทักษะ Linux การเขียน Python หรือ R การจัดการตาราง และสถิติที่เกี่ยวข้อง EMBL-EBI มีชุดบทเรียนเบื้องต้นสำหรับฝึกใช้ทรัพยากรเหล่านี้ [12]
คุณค่าของ Bioinformatics อยู่ที่การเชื่อมข้อมูลกับคำถามทางชีววิทยาอย่างตรวจสอบได้ เครื่องมือช่วยให้ทำงานกับข้อมูลซับซ้อนและวางแผนการทดลองได้ดีขึ้น ส่วนความเข้าใจที่นำไปใช้จริงต้องอาศัยการตรวจคุณภาพ การตีความความไม่แน่นอน และหลักฐานที่เหมาะสมกับข้อสรุปนั้น
อ้างอิง
- National Human Genome Research Institute (NHGRI). Bioinformatics. Genetics Glossary. (เข้าถึง 13 ตุลาคม 2026).
- European Bioinformatics Institute (EMBL-EBI). Services.(เข้าถึง 13 ตุลาคม 2026).
- Heumos L, Schaar AC, Lance C, et al. Best practices for single-cell analysis across modalities. Nature Reviews Genetics. 2023;24:550–572. doi:10.1038/s41576-023-00586-w.
- National Center for Biotechnology Information (NCBI). BLAST: Basic Local Alignment Search Tool. เครื่องมือและคำอธิบาย (เข้าถึง 13 ตุลาคม 2026).
- Liao WW, Asri M, Ebler J, et al. A draft human pangenome reference. Nature. 2023;617:312–324. doi:10.1038/s41586-023-05896-x.
- Logsdon GA, Ebert P, Audano PA, et al. Complex genetic variation in nearly complete human genomes. Nature. 2025;644:430–441. doi:10.1038/s41586-025-09140-6. อ่านร่วมกับ Author Correction. Nature. 2025;645:E6. doi:10.1038/s41586-025-09547-1.
- Abramson J, Adler J, Dunger J, et al. Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature. 2024;630:493–500. doi:10.1038/s41586-024-07487-w.
- EMBL-EBI Training. What AlphaFold 3 struggles with. AlphaFold: A practical guide. บทเรียนข้อจำกัดของแบบจำลอง (เข้าถึง 13 ตุลาคม 2026).
- Richards S, Aziz N, Bale S, et al. Standards and guidelines for the interpretation of sequence variants: a joint consensus recommendation of the American College of Medical Genetics and Genomics and the Association for Molecular Pathology. Genetics in Medicine. 2015;17:405–423. doi:10.1038/gim.2015.30.
- Clinical Genome Resource (ClinGen). Sequence Variant Interpretation. คำแนะนำประกอบการใช้เกณฑ์แปลผล (เข้าถึง 13 ตุลาคม 2026).
- Wilkinson MD, Dumontier M, Aalbersberg IJ, et al. The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data. 2016;3:160018. doi:10.1038/sdata.2016.18.
- EMBL-EBI Training. Introductory bioinformatics. ชุดบทเรียนเบื้องต้น (เข้าถึง 13 ตุลาคม 2026).
- Luecken MD, Theis FJ. Current best practices in single-cell RNA-seq analysis: a tutorial. Molecular Systems Biology. 2019;15:e8746. doi:10.15252/msb.20188746.
21 เมษายน 2010 16:12
Bioinformatics เรียกเป็นภาษาไทยว่า ชีวสารสนเทศศาสตร์ มีจุดประสงค์เพื่อบริหารจัดการข้อมูลด้านชีววิทยาที่มีจำนวนมากๆ ใช้กับการวิจัยทางด้านเภสัชศาสตร์ก็ได้นะ
21 เมษายน 2010 16:21
ขอบคุณมากครับ สำหรับข้อมูล รายละเอียดมีอีกเยอะมากครับยังไม่มีเวลาเพิ่มเติม ที่จริงแล้วบทความนี้เป็นของคุณ Temsiri ครับ ต้องให้เคดิตเขาล่ะ