
สมาคม Society for Neuroscience ได้แถลงผลงานวิจัยด้าน อินเทอร์เฟซสมอง-คอมพิวเตอร์ (Brain-Computer Interface หรือ BCI) ชุดใหม่ 3 ชิ้น ซึ่งจะนำเสนอในที่ประชุมวิชาการ Neuroscience 2026 ที่กรุงวอชิงตัน ดี.ซี. โดยทั้งหมดมุ่งไปที่โจทย์เดียวกัน คือการคืนความสามารถในการสื่อสารให้ผู้ที่สูญเสียการพูดหรือการเคลื่อนไหวโดยสมัครใจจากโรคทางระบบประสาท
สรุปสาระสำคัญ
- เสียงสังเคราะห์จาก BCI ที่ควบคุมระดับเสียงสูงต่ำได้ ทำให้ผู้ป่วยร้องเพลงสั้น ๆ และผู้ฟังเข้าใจคำพูดได้ดีขึ้น
- ผู้ป่วยในภาวะ locked-in อย่างสมบูรณ์ สื่อสารได้ด้วยตนเองต่อเนื่องนานกว่า 1 ปี
- ระบบแปลสัญญาณสมองเป็นข้อความแบบพกพา ทำงานได้แม้บน iPhone
- เป็นการนำเสนอในที่ประชุม จึงยังไม่ผ่านการตรวจทานแบบ peer review ทั้งหมด
เสียงที่มีอารมณ์ ไม่ใช่แค่ตัวอักษร
ทีมของ Maitreyee Wairagkar จาก University of California, Davis รายงานระบบ BCI ที่สร้างเสียงสังเคราะห์ซึ่งเก็บรายละเอียดของระดับเสียงสูงต่ำ (pitch) ไว้ได้ ผลคือผู้ป่วยสามารถเน้นคำ ตั้งคำถาม และกระทั่งร้องทำนองสั้น ๆ ได้ ขณะที่ผู้ฟังเข้าใจเนื้อความได้ดีขึ้นกว่าระบบเดิม
งานของทีม UC Davis เคยตีพิมพ์หลักการนี้ไว้ในวารสาร Nature เมื่อปี 2025 ภายใต้ชื่อ instantaneous voice synthesis ซึ่งแปลงกิจกรรมของเซลล์ประสาทเป็นคลื่นเสียงโดยตรง เสมือนสร้าง “ทางเดินเสียงดิจิทัล” ขึ้นมาแทนกล้ามเนื้อที่ทำงานไม่ได้ (ภาพที่ 1)
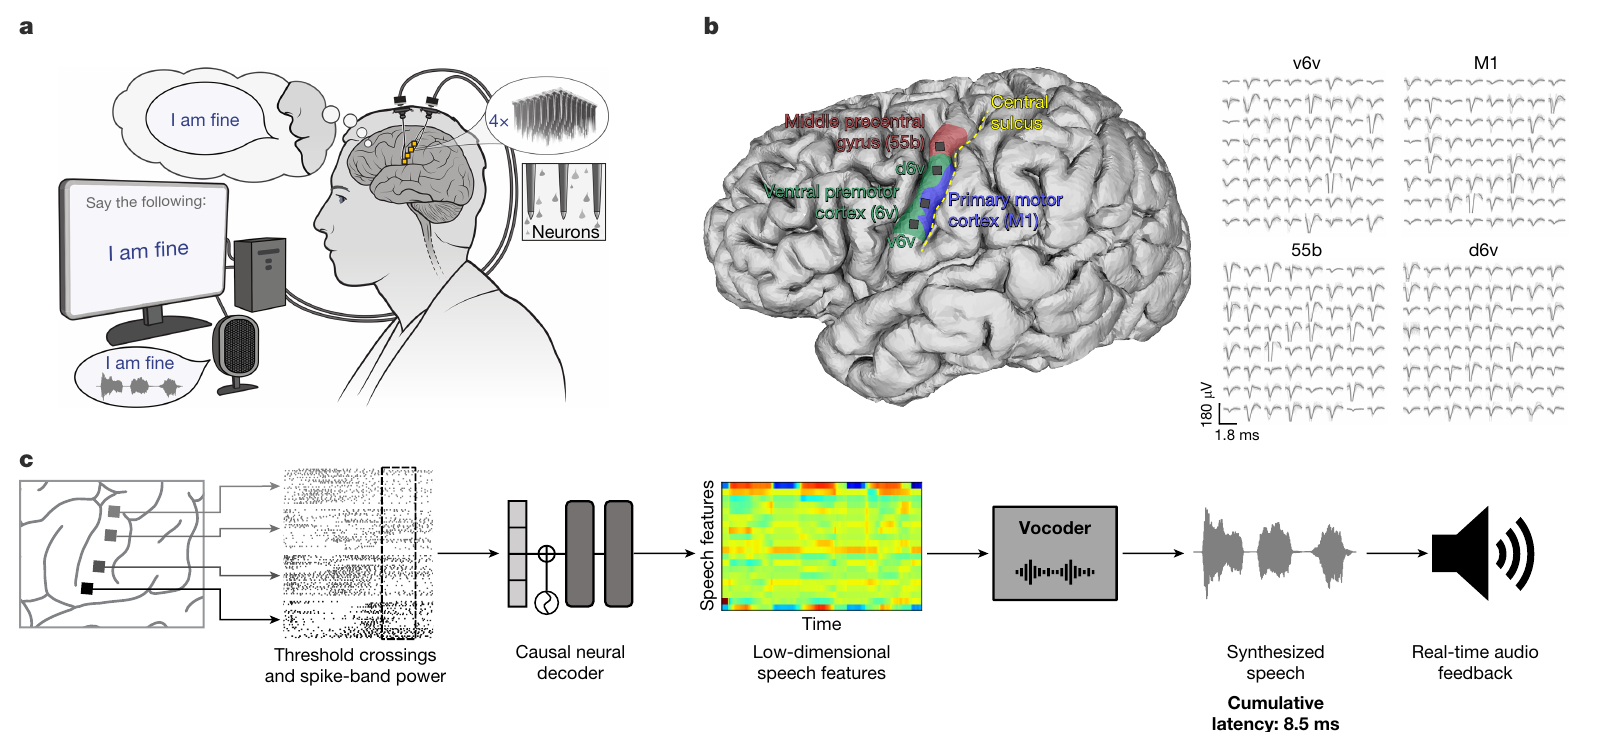
ผู้ร่วมวิจัยคือชายอายุ 45 ปีที่มีภาวะ ALS และพูดไม่ชัดอย่างรุนแรง (severe dysarthria) เขาได้รับการผ่าตัดฝังขั้วไฟฟ้าแบบ Utah array จำนวน 4 ชุด ชุดละ 64 ขั้ว รวมเป็น 256 ขั้ว ในสมองกลีบหน้าซีกซ้ายบริเวณ precentral gyrus ระบบจะสกัดลักษณะสัญญาณประสาทจากทั้ง 256 ช่องแล้วรวมเป็นช่วงละ 10 มิลลิวินาที แล้วส่งให้โมเดลปัญญาประดิษฐ์แบบ Transformer ทำนายคุณสมบัติของเสียงและระดับเสียงออกมาเป็นคลื่นเสียงจริง จุดสำคัญคือโมเดลนี้ทำงานแบบ causal คือใช้เฉพาะสัญญาณที่ผ่านมาแล้วเท่านั้น ไม่ต้องรอข้อมูลในอนาคต ขั้นตอนตั้งแต่รับสัญญาณประสาทจนได้ตัวอย่างเสียงสังเคราะห์ใช้เวลาไม่ถึง 10 มิลลิวินาที จากนั้นระบบเล่นเสียงผ่านลำโพงอย่างต่อเนื่อง ให้ผู้ร่วมวิจัยได้ยินเสียงของตัวเองขณะพยายามพูดและปรับจังหวะกับน้ำเสียงได้
เสียงที่สังเคราะห์ได้ ผู้ฟังเข้าใจแค่ไหน
ระบบนี้สร้างเสียงจากสัญญาณประสาทโดยตรงระหว่างที่ผู้ร่วมวิจัยพยายามพูด ส่วน BCI บางระบบถอดสัญญาณเป็นข้อความก่อน แล้วจึงใช้โปรแกรมอ่านออกเสียงเมื่อได้ประโยคครบ ทีมวิจัยประเมินว่าผู้ฟังเข้าใจเสียงจากระบบนี้ได้แค่ไหนด้วยการให้เลือกประโยคที่ได้ยินและถอดความแบบอิสระ (ภาพที่ 2)
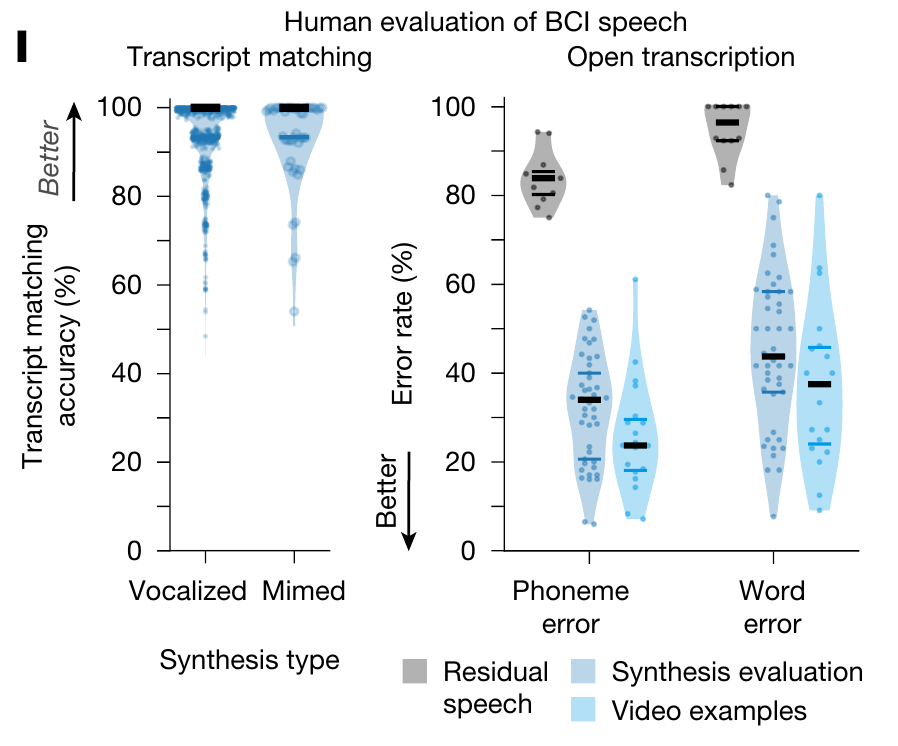
ทีมวิจัยวัดความเข้าใจของผู้ฟังสองวิธี วิธีแรกให้ผู้ฟังจับคู่ประโยคที่ได้ยินกับตัวเลือก 6 ข้อ จากประโยคทดสอบ 956 ประโยค ได้ความถูกต้องเฉลี่ย 94.34% วิธีที่สองให้ผู้ฟังที่ไม่เคยฝึกมาก่อนถอดความแบบอิสระ พบอัตราความผิดพลาดระดับหน่วยเสียง (phoneme error rate) ที่ค่ามัธยฐาน 34.00% และระดับคำ (word error rate) 43.75% ขณะที่เสียงพูดเดิมของผู้ป่วยเองถูกถอดความโดยผู้ฟังกลุ่มเดียวกันด้วยความผิดพลาด 83.87% และ 96.43% ตามลำดับ ตัวเลขนี้ชี้ว่าเสียงจาก BCI เข้าใจได้ง่ายกว่าเสียงพูดที่เหลืออยู่ของเขาอย่างชัดเจน
ใช้งานได้จริงนอกห้องแล็บ
Daniel Rubin จาก Massachusetts General Hospital รายงานกรณีผู้ป่วยในภาวะ locked-in อย่างสมบูรณ์ (completely locked-in state) คือไม่สามารถขยับกล้ามเนื้อส่วนใดได้เลย แต่สามารถสื่อสารได้ด้วยตนเองต่อเนื่องนานกว่าหนึ่งปี ผ่าน BCI ที่ถอดรหัสความตั้งใจจะเคลื่อนไหวจากกิจกรรมของสมอง
ส่วน Chethan Pandarinath จาก Georgia Institute of Technology และ Emory University นำเสนอระบบ brain-to-text แบบพกพา ที่ถอดรหัสสัญญาณสมองเป็นคำเขียนได้อย่างแม่นยำและเสถียร โดยทำงานได้แม้บนโทรศัพท์ iPhone ซึ่งเป็นประเด็นที่น่าสนใจอย่างมากในเชิงวิศวกรรม เพราะการย้ายการประมวลผลจากคอมพิวเตอร์ในห้องวิจัยมาอยู่บนอุปกรณ์ขนาดเล็กที่ผู้ป่วยพกติดตัว คือเงื่อนไขจำเป็นที่จะทำให้เทคโนโลยีนี้ออกจากการทดลองไปสู่ชีวิตประจำวันได้
“ความสามารถในการถอดรหัสและแปลงกิจกรรมของสมองเป็นคำพูดหรือคำเขียน มีศักยภาพที่จะเปลี่ยนชีวิตของผู้ป่วยอัมพาตได้”
Cynthia Chestek วิศวกรชีวการแพทย์จาก University of Michigan ผู้ดำเนินรายการแถลงข่าว
ข้อควรระวัง
ผลงานที่แถลงในที่ประชุมทั้งสามชิ้นนี้ยังไม่ได้ผ่านการตรวจทานโดยผู้ทรงคุณวุฒิครบถ้วนทุกชิ้น มีเพียงหลักการของระบบสังเคราะห์เสียงเท่านั้นที่ตีพิมพ์เป็นรายงานวิจัยใน Nature แล้ว นอกจากนี้ข้อมูลทั้งหมดมาจากผู้ป่วยในการทดลองทางคลินิกจำนวนน้อยราย บางชิ้นเป็นผู้ป่วยเพียงรายเดียว เทคโนโลยี BCI ยังจัดเป็นอุปกรณ์เพื่อการวิจัย (investigational device) ที่ยังไม่ได้รับอนุมัติให้ใช้ทั่วไป
ดังนั้น ภาพรวมที่เห็นจาก Neuroscience 2026 คือทิศทางการพัฒนาที่ขยับจากคำถามว่า “ถอดรหัสสมองได้หรือไม่” ไปสู่คำถามที่ใช้งานจริงมากขึ้น นั่นคือจะทำให้มันเป็นธรรมชาติ พกพาได้ และใช้ได้ต่อเนื่องในบ้านของผู้ป่วยเองได้อย่างไร
สำหรับผู้ที่สนใจพื้นฐานของเทคโนโลยีนี้ สามารถอ่านเพิ่มเติมได้ที่บทความ Brain–Computer Interface (BCI) คืออะไร: เปลี่ยนสัญญาณสมองเป็นคำสั่งได้อย่างไร และบทความที่เกี่ยวข้องอย่าง Rehabilitation Engineering คืออะไร กับ Phantom X เริ่มทดลองในคน ใช้เซนเซอร์ใต้ผิวหนังควบคุมแขนเทียม
สำหรับคนที่สนใจสามารถเข้าไปศึกษารายละเอียดของรายงานวิจัยที่รองรับงานเสียงสังเคราะห์ได้ที่ An instantaneous voice-synthesis neuroprosthesis (Nature เล่ม 644, 2025)
ข่าวจาก Brain-computer interfaces: A new voice for people with paralysis — Society for Neuroscience